《人工智能》一书介绍了整个人工智能系统和agent的发展历程,作者尼尔森,机械工业出版社出版发行。
本页面主要目录有关于人工智能的:内容简介、作品目录等介绍

《人工智能》一书介绍了整个人工智能系统和agent的发展历程,作者尼尔森,机械工业出版社出版发行。
本页面主要目录有关于人工智能的:内容简介、作品目录等介绍
尼尔森
317 页
简装本
2003年12月
30 元
9787111078852
《人工智能》从一个新颖的角度对人工智能各方面的问题进行了探讨。由浅入深地介绍了整个人工智能系统和agent的发展历程。首先,描述了仅能对周围环境中可感知特征做出反应的原始agent,以及它们所涉及的机器视觉、机器学习和机器进化等问题;然后,逐步介绍了agent可以从无法立即感知的任务环境中获取信息的技术。《人工智能》不仅是对人工智能技术的介绍,而且能为人工智能的研究提供参考和建议。《人工智能》作为人工智能的入门教材,适合所有对人工智能这门学科感兴趣的读者参考,尤其适合大专院校的计算机专业及相关专业的学生用做教材或教学参考书。
第一部分 响应机器 | ||
译者序 | 第2章 刺激响应agent 13 | 第3章 神经网络 23 |
前言 | 2.1 感知和动作 13 | 3.1 引言 23 |
第1章 绪论 1 | 2.1.1 感知 15 | 3.2 训练单个TLU 23 |
1.2 人工智能的研究方法 4 | 2.1.2 动作 15 | 3.2.1 TLU几何学 23 |
1.3 人工智能简史 5 | 2.1.3 布尔代数 16 | 3.2.2 扩充向量 24 |
1.4 《人工智能》规划 7 | 2.1.4 布尔函数的类别和形式 16 | 3.2.3 梯度下降方法 24 |
1.5 补充读物和讨论 9 | 2.2 动作函数的表达和执行 17 | 3.2.4 Widrow-Hoff程序 25 |
2.2.1 产生式系统 17 | 3.2.5 一般化Delta程序 26 | |
2.2.2 网络 18 | 3.2.6 纠错程序 27 | |
2.2.3 包含体系结构 20 | 3.3 神经网络 28 | |
2.3 补充读物和讨论 21 | 3.3.1 动机 28 | |
3.3.2 表示符号 28 | ||
3.3.3 反向传播方法 29 | ||
3.3.4 计算最后一层的权值变化 30 | ||
3.3.5 计算中间层的权值变化 30 | ||
3.4 一般化、准确度和过度拟合 32 | ||
3.5 补充读物和讨论 34 |
第4章 机器进化 37 | 第5章 状态机 45 | 第6章 机器人视觉 53 |
4.1 进化计算 37 | 5.1 用特征向量来表示环境 45 | 6.1 引言 53 |
4.2 遗传编程 37 | 5.2 Elman网络 46 | 6.2 操纵一辆汽车 54 |
4.2.1 遗传编程的程序表示 37 | 5.3 图标表示 47 | 6.3 机器人视觉的两个阶段 55 |
4.2.2 遗传编程过程 39 | 5.4 黑板系统 49 | 6.4 图象处理 56 |
4.2.3 进化一个沿墙运动的机器人 40 | 5.5 补充读物和讨论 50 | 6.4.1 平均法 56 |
4.3 补充读物和讨论 43 | 6.4.2 边缘增强 58 | |
6.4.3 边缘增强与平均法的结合 59 | ||
6.4.4 区域查找 61 | ||
6.4.5 运用亮度以外的其他图象的属性 62 | ||
6.5 场景分析 63 | ||
6.5.1 解释图象中的线条和曲线 63 | ||
6.5.2 基于模型的视觉 65 | ||
6.6 立体视觉和深度信息 66 | ||
6.7 补充读物和讨论 67 |
第二部分 状态空间搜索 | ||
第7章 能计划的agent 71 | 第8章 盲目搜索 78 | 第9章 启发式搜索 84 |
7.1 存储与计算 71 | 8.1 用公式表示状态空间 78 | 9.1 使用评估函数 84 |
7.2 状态空间图 72 | 8.2 隐式状态空间图的组成 78 | 9.2 一个通用的图搜索算法 85 |
7.3 显式状态空间搜索 74 | 8.3 广度优先搜索 79 | 9.2.1 算法A* 86 |
7.4 基于特征的状态空间 74 | 8.4 深度优先或回溯搜索 80 | 9.2.2 A*的可接纳性 88 |
7.5 图记号 75 | 8.5 迭代加深 81 | 9.2.3 一致性(或单调)条件 91 |
7.6 补充读物和讨论 76 | 8.6 补充读物和讨论 82 | 9.2.4 迭代加深的A* 92 |
9.2.5 递归最优搜索 93 | ||
9.3 启发式函数和搜索效率 94 | ||
9.4 补充读物和讨论 97 |
第10章 计划、动作和学习 99 | 第11章 其他搜索公式及其应用 111 | 第12章 敌对搜索 118 |
10.1 感知/计划/动作循环 99 | 11.1 赋值问题 111 | 12.1 双agent博弈 118 |
10.2 逼近搜索 100 | 11.2 构造性方法 112 | 12.2 最小最大化过程 119 |
10.2.1 孤岛驱动搜索 100 | 11.3 启发式修补 114 | 12.3 a -b 过程 122 |
10.2.2 层次搜索 101 | 11.4 函数优化 115 | 12.4 a -b 过程的搜索效率 125 |
10.2.3 有限范围搜索 102 | 12.5 其他重要问题 125 | |
10.2.4 循环 103 | 12.6 概率博弈 126 | |
10.2.5 建立反应过程 104 | 12.7 学习评估函数 127 | |
10.3 学习启发式函数 105 | 12.8 补充读物和讨论 128 | |
10.3.1 显式图 105 | ||
10.3.2 隐式图 106 | ||
10.4 奖赏代替目标 107 | ||
10.5 补充读物和讨论 108 |
第三部分 知识的表示和推理 | ||
第13章 命题演算 131 | 第14章 命题演算中的归结 140 | 第15章 谓词演算 146 |
13.1 对特征值加以约束 131 | 14.1 一种新的推理规则:归结 140 | 15.1 动机 146 |
13.2 语言 132 | 14.1.1 作为合式公式的子句 140 | 15.2 谓词演算语言和它的句法 146 |
13.3 推理规则 133 | 14.1.2 子句上的归结 140 | 15.3 语义 147 |
13.4 验证定义 133 | 14.1.3 归结的合理性 141 | 15.3.1 世界 147 |
13.5 语义 134 | 14.2 转换任意的合式公式为子句的合取式 141 | 15.3.2 解释 147 |
13.5.1 解释 134 | 14.3 归结反驳 142 | 15.3.3 模型及其相关的概念 148 |
13.5.2 命题真值表 134 | 14.4 归结反驳搜索策略 142 | 15.3.4 知识 149 |
13.5.3 可满足性与模型 135 | 14.4.1 排序策略 143 | 15.4 量化 150 |
13.5.4 永真性 136 | 14.4.2 精确策略 143 | 15.5 量词语义学 150 |
13.5.5 等价 136 | 14.5 Horn 子句 144 | 15.5.1 全称量词 150 |
13.5.6 涵蕴 136 | 15.5.2 存在量词 151 | |
13.6 合理性和完备性 137 | 15.5.3 有用的等价式 151 | |
13.7 命题可满足性问题 137 | 15.5.4 推理规则 151 | |
13.8 另一些重要的问题 138 | 15.6 谓词演算作为一种表示知识的语言 151 | |
13.8.1 语言差异 138 | 15.6.1 概念化 151 | |
13.8.2 元定理 138 | 15.6.2 举例 152 | |
13.8.3 结合律 139 | 15.7 补充读物和讨论 153 | |
13.8.4 分配律 139 |
第16章 谓词演算中的归结 155 | 第17章 基于知识的系统 166 | 第18章 表示常识知识 187 |
16.1 合一 155 | 17.1 面对现实世界 166 | 18.1 常识世界 187 |
16.2 谓词演算归结 157 | 17.2 用Horn子句进行推理 166 | 18.1.1 什么是常识知识 187 |
16.3 完备性和合理性 158 | 17.3 动态知识库的维持 170 | 18.1.2 表示常识知识的困难 188 |
16.4 把任意的合式公式转化为子句形式 158 | 17.4 基于规则的专家系统 173 | 18.1.3 常识知识的重要性 189 |
16.5 用归结证明定理 160 | 17.5 规则学习 176 | 18.1.4 研究领域 189 |
16.6 回答提取 161 | 17.5.1 学习命题演算规则 177 | 18.2 时间 190 |
16.7 等式谓词 161 | 17.5.2 学习一阶逻辑规则 180 | 18.3 用网络表示知识 191 |
16.8 补充读物和讨论 163 | 17.5.3 基于解释的一般化 183 | 18.3.1 分类的知识 191 |
17.6 补充读物和讨论 184 | 18.3.2 语义网络 192 | |
18.3.3 语义网络的非单调推理 193 | ||
18.3.4 框架 194 | ||
18.4 补充读物和讨论 194 |
第19章 用不确定信息进行推理 197 | 第20章 用贝叶斯网学习和动作 214 | 第四部分 基于逻辑的规划方法 |
19.1 概率论简介 197 | 20.1 学习贝叶斯网 214 | 第21章 状态演算 227 |
19.1.1 基本思想 197 | 20.1.1 已知网络结构 214 | 21.1 状态和动作推理 227 |
19.1.2 条件概率 199 | 20.1.2 学习网络结构 216 | 21.2 存在的一些困难 229 |
19.2 概率推理 201 | 20.2 概率推理与动作 219 | 21.2.1 框架公理 229 |
19.2.1 一个一般的方法 201 | 20.2.1 一般设置 219 | 21.2.2 条件 230 |
19.2.2 条件独立 202 | 20.2.2 一个扩展的例子 220 | 21.2.3 分枝 230 |
19.3 贝叶斯网 203 | 20.2.3 一般化举例 222 | 21.3 生成计划 231 |
19.4 贝叶斯网的推理模式 204 | 20.3 补充读物和讨论 223 | 21.4 补充读物和讨论 231 |
19.5 不确定证据 205 | ||
19.6 D 分离 205 | ||
19.7 在polytree中的概率推理 206 | ||
19.7.1 证据在上方 207 | ||
19.7.2 证据在下方 208 | ||
19.7.3 证据在上下两方 209 | ||
19.7.4 一个数值例子 210 | ||
19.8 补充读物和讨论 211 |
第22章 规划 234 | 第五部分 通信与集成 | 第24章 agent之间的通信 263 |
22.1 STRIPS规划系统 234 | 第23章 多agent 255 | 24.1 交谈 263 |
22.1.1 描述状态和目标 234 | 23.1 交互agent 255 | 24.1.1 计划交谈 264 |
22.1.2 向前搜索方法 235 | 23.2 其他agent模型 255 | 24.1.2 实现交谈 264 |
22.1.3 递归STRIPS 236 | 23.2.1 模型种类 255 | 24.2 理解语言字符串 265 |
22.1.4 带有运行时条件的计划 238 | 23.2.2 模拟策略 256 | 24.2.1 短语结构语法 265 |
22.1.5 Sussman异常 238 | 23.2.3 模拟数据库 257 | 24.2.2 语义分析 267 |
22.1.6 向后搜索方法 239 | 23.2.4 有意思维方式 257 | 24.2.3 扩展语法 271 |
22.2 计划空间和部分有序规划 242 | 23.3 知识模式逻辑 258 | 24.3 有效通信 272 |
22.3 层次规划 246 | 23.3.1 模式算子 258 | 24.3.1 上下文的使用 272 |
22.3.1 ABSTRIPS 246 | 23.3.2 知识公理 259 | 24.3.2 使用知识解决歧义性 273 |
22.3.2 层次规划和部分有序规划的组合 248 | 23.3.3 关于其他agent知识的推理 260 | 24.4 自然语言处理 274 |
22.4 学习计划 248 | 23.3.4 预测其他agent的动作 261 | 24.5 补充读物和讨论 275 |
22.5 补充读物和讨论 250 | 23.4 补充读物和讨论 261 |
第25章 agent体系结构 277 | |
25.1 三级体系结构 277 | 参考文献 282 |
25.2 目标仲裁 278 | |
25.3 三层塔式结构 279 | |
25.4 自举 280 | |
25.5 补充读物和讨论 280 |
新亚洲娱乐(英文名:ASIA ENTERTAINMENT GROUP LIMITED,全称:新亚洲娱乐联盟集团有限公司)是一家以从事戏剧制作人及杂项戏剧服务为主的企业,成立于1999年,位于香港特别行政区。旗下分公司包括虎威艺能创作有限公司(TGS HK)、稻草人娱乐创作社(Scarecrow Entertainment)、虎威王朝音乐创作股份有限公司(TGS Music)、虎威活力娱乐传播有限公司(TGS Taiwan)、AK Entertainment(Korea)以及AEG Korea等。
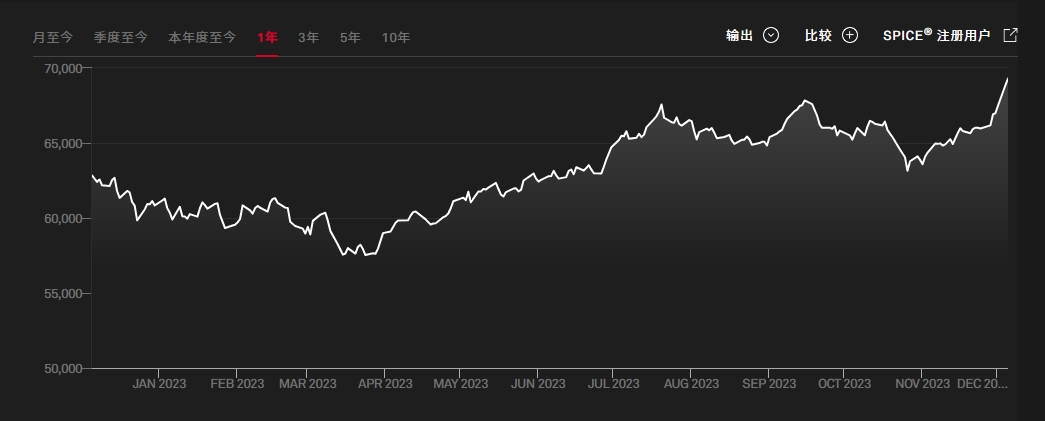
印度孟买SENSEX30指数(又称孟买敏感指数)为印度最被广泛使用的指数,为投资印度的重要参考指标,是由孟买证券交易所发行。由于各类媒体提到的“印度股市”,实际上都是孟买股票交易所,因此,该交易所的SENSEX-30指数几乎成了印度股市的代名词。